Este martes 20 de octubre, Data Observatory participó en RISE AI Latin America Summit, encuentro organizado por la Universidad de los Andes y el Lucy Family Institute For Data & Society de la Universidad de Notre Dame, que reunió a expertos de distintas disciplinas para abordar el desarrollo de una inteligencia artificial responsable, inclusiva, segura y empoderadora.
El congreso exploró el impacto de la IA en las dimensiones de educación, negocios, salud y biotecnología. En este último escenario, una de las grandes preocupaciones de la región es la salud mental. Según cifras recientes, un 18,5% de la población en Chile presenta sospecha o problemas de salud mental, de acuerdo al Termómetro de la Salud Mental ACHS-UC (2026), mientras que las estadísticas oficiales del MINSAL y el DEIS registran una tasa de 10,3 suicidios por cada 100.000 habitantes y un 19% con síntomas de depresión o ansiedad (ENCAVI).
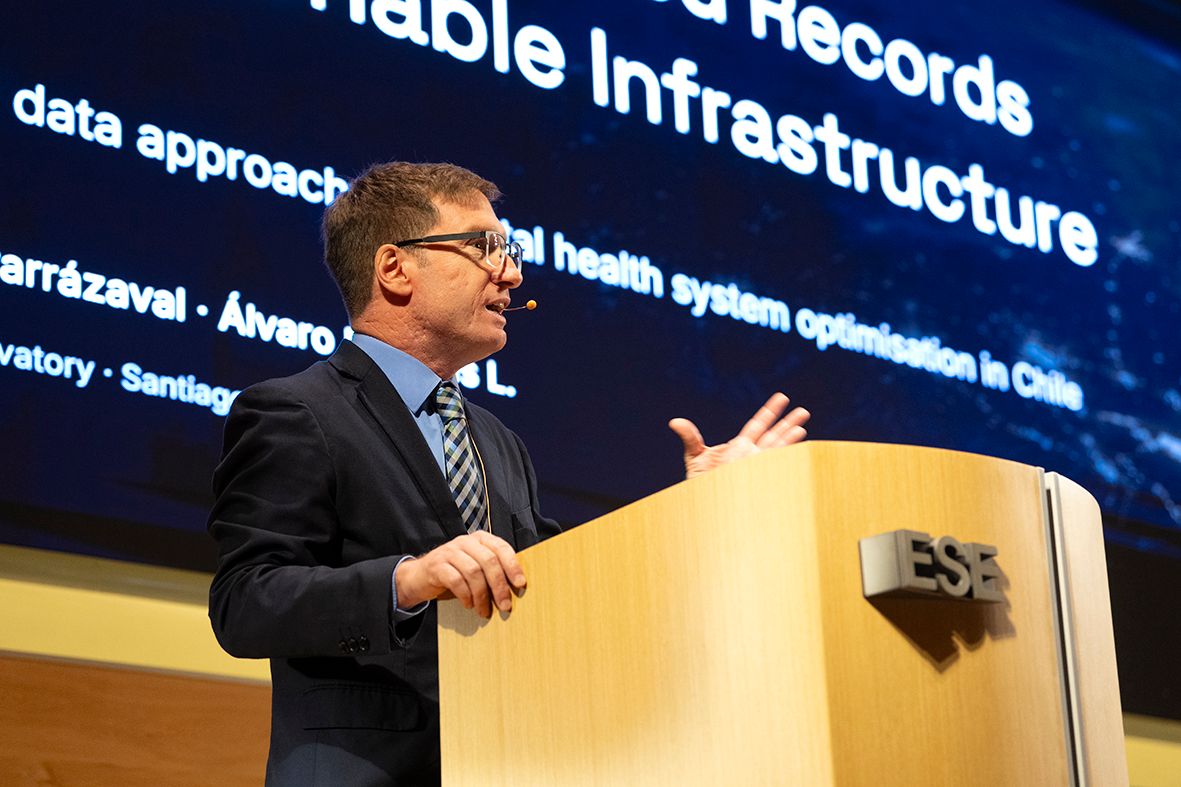
En este sentido, Álvaro Paredes, director de tecnología de Data Observatory y Matías Irarrázaval, psiquiatra, investigador asociado y académico de la Universidad de Chile, presentaron un proyecto que forma parte de un “lago de datos”, que permitirá conectar y disponibilizar datos públicos de salud, para contribuir a mejorar la información disponible para la investigación, la toma de decisiones y la planificación de la salud en Chile, con un piloto enfocado en registros de salud mental.
La propuesta parte de una brecha concreta. Actualmente, estos datos públicos están estructurados de una forma que no permiten responder con facilidad tres preguntas fundamentales para la gestión sanitaria: quiénes necesitan atención en salud mental y por qué condición, dónde se encuentran y si reciben atención, y cuánto tiempo deben esperar para acceder a la misma.
“Hasta ahora este proyecto se centra en datos habilitantes en salud mental, pero tenemos otros conjuntos de datos que estamos trabajando en el área de salud, y que podrían ampliar su impacto en otras problemáticas del área. La idea es habilitar el análisis de la información sin tener que hacer toda esa búsqueda y estandarización que normalmente uno tiene que hacer cuando trabaja con datos. Se trata de una solución innovadora que permite desarrollar modelos estadísticos y de IA (machine learning o LLMs), para sacar las conclusiones o responder las preguntas necesarias”, explica Álvaro Paredes sobre esta iniciativa.
Por su parte, Matías Irarrázaval profundizó en el potencial de este trabajo para abordar desafíos del sistema de salud, “como las listas de espera, al permitir identificar con mayor precisión dónde existen brechas de atención y qué grupos de personas están quedando rezagados. También puede entregar información clave para la gestión sanitaria, facilitando el análisis de los volúmenes de atención y su distribución en el tiempo, para apoyar una mejor planificación de los servicios. Además, al integrar distintas fuentes de información, abre nuevas oportunidades para investigar fenómenos de salud pública y comprender mejor factores asociados a problemas como el suicidio o el cáncer”.
La herramienta utiliza como punto de partida las estadísticas mensuales publicadas por el Departamento de Estadísticas e Información de Salud (DEIS), que tras un proceso de estructuración y estandarización, se organizan en tablas con criterios consistentes entre distintos años, acompañadas de diccionarios que describen sus variables en lenguaje claro.
Además, cada conjunto de datos contará con un identificador digital de objeto (DOI), que permite identificarlo y referenciarlo, junto con sus distintas versiones. De esta manera, la información resulta más fácil de localizar, consultar y reutilizar en investigaciones y análisis posteriores.
Este conjunto de datos de salud, próximo a ser lanzado por Data Observatory, permitirá realizar consultas sobre registros de distintos establecimientos y construir series temporales a escala nacional, sin tener que procesar manualmente cada archivo por separado.
Si bien para desarrollar esta solución se trabajó en una primera etapa con datos de salud mental, el objetivo es más amplio: avanzar hacia una arquitectura completa de datos de salud que facilite la integración y reutilización de información pública bajo principios FAIR: datos encontrables, accesibles, interoperables y reutilizables.
Entre los próximos pasos se encuentran avanzar en un acuerdo específico con el DEIS para acceder a más información, incorporar nuevas fuentes, como egresos hospitalarios, atenciones de urgencia, mortalidad y listas de espera; y desarrollar un piloto en la Región Metropolitana, con posibilidades de replicación en otras regiones.
La infraestructura considera distintos niveles de acceso, de acuerdo con la naturaleza de los datos y los resguardos necesarios para su uso. Los indicadores agregados pueden ser de acceso abierto, mientras que los datos no identificados pueden requerir condiciones específicas de utilización. Por su parte, los microdatos sensibles contemplan acceso restringido a proyectos aprobados y bajo condiciones de seguridad.
Este enfoque busca compatibilizar la reutilización de datos para la investigación y la toma de decisiones con la protección de la información personal, considerando el marco normativo chileno en esta materia.
Voz en el eje de Salud
La participación de Data Observatory en RISE AI Latin America 2026 se enmarcó en uno de los tres ejes programáticos del evento, Salud y Biotecnología. En él se abordó el potencial de la inteligencia artificial para la biomedicina, la salud digital y la innovación responsable, con conversatorios, presentaciones, casos de uso y experiencias internacionales, con representantes de instituciones como Google, el Sanford Stem Cell Institute y Surescripts.
“Participar en RISE AI Latin America Summit es una oportunidad para compartir experiencias, conectar capacidades y mostrar cómo los datos pueden contribuir a resolver desafíos concretos de nuestra sociedad a través de la inteligencia artificial. Las experiencias, miradas y conversaciones del evento son valiosas para una institución como Data Observatory, que busca consolidarse como la infraestructura habilitante para la gestión, integración y disponibilidad de datos”, comentó Rodrigo Roa, director ejecutivo de Data Observatory y coordinador programático del encuentro.
En esa línea, Nitesh Chawla, director fundador de Lucy Family Institute For Data & Society, señaló que al reflexionar sobre IA, cabe preguntarse qué implica desarrollar modelos de IA en Chile. Y añadió: “ Para las personas y las organizaciones del país, un aspecto fundamental son los datos. ¿de dónde provienen? ¿quién los selecciona y organiza?¿quién actúa como proveedor o fuente de datos confiables?. Data Observatory es esa organización esencial que puede funcionar como una autopista de datos, sirviendo tanto como fuente de información como entidad encargada de la recopilación de datos”.
"Este evento lo organizamos junto a Data Observatory, un gran socio con el que llevamos más de dos años trabajando en conjunto. Quisimos traer a Chile la experiencia y el conocimiento desarrollados en la Universidad de Notre Dame a través de su framework RISE, y explorar cómo podíamos aplicar estas metodologías utilizando tecnología chilena”, señaló Anil Sadarangani, director de innovación de la Universidad de los Andes. “En ese contexto, Data Observatory ha sido un aliado clave, desarrollando investigación de primer nivel y contribuyendo a resolver desafíos de la sociedad chilena mediante el uso de datos y tecnologías de inteligencia artificial”, agregó.
El encuentro se realizó del 20 al 21 de octubre en la Universidad de los Andes, y tuvo entre sus invitados a representantes de OpenAI, Anthropic e IBM, entre otras organizaciones de tecnología, y contó con el apoyo de Data Observatory y LarraínVial.